Zkoušení, spolehlivost a kvalita
Deep learning pro vizuální kontrolu kódových kotoučů: co umí a na co dát pozor
AOI založené na pravidlech nikdy neunikne rozměrovým vadám, ale často je zaplaveno pseudo-vadami jako částice a skvrny; deep learning dobře odděluje vzhledové třídy, ale závisí na vzorcích a prahech. Článek porovnává oba rozsahy použití, ukazuje na simulovaných datech trade-off prahu, overkillu a escape a práh s minimálními náklady a počítá, kolik vadných vzorků je potřeba k ověření míry escape.
Vizuální kontrola kódových kotoučů hledá smíšený balík vad: chromové pinholy, mosty zbytkového chromu, přerušené rysky, škrábance, částice, odštěpky okraje, skvrny. AOI založené na pravidlech umí porovnat obraz s návrhem pixel po pixelu a je spolehlivé u rozměrových rozhodnutí, ale je citlivé na «jiné» a tupé na «zda jiné záleží»; jeden kotouč může vyhodit desítky kandidátů, většinou prach a neškodné vlnění okraje, a lidská překontrola to uzavře. Deep learning se zdá přesně zaplňovat tuto mezeru — ale mění problém z «ladění parametrů» na «řízení dat a prahů».
Co umí AOI založené na pravidlech a deep learning
| Dimenze | AOI založené na pravidlech | Deep learning |
|---|---|---|
| Princip | Porovnání s návrhem nebo zlatým vzorkem, prahy, morfologie, rozměrové měření | Učit se rysy vad z označených vzorků; výstup třídy nebo pixelové segmentace |
| Potřebné vzorky | V podstatě žádné vadné vzorky | Dostatek reprezentativních označených vzorků |
| Rozměrová rozhodnutí | Silná; možné hodnocení nejistoty | Slabá; nevhodná jako přímé měření |
| Vzhledová rozhodnutí | Slabá; mnoho pseudo-vad | Silná; umí oddělit částice a skvrny od pravých vad |
| Drift osvětlení / procesu | Citlivé; opakované doladění | Poměrně robustní k variacím pokrytým trénovací sadou; nepokryté mohou selhat |
| Interpretovatelnost a sledovatelnost | Pravidla jsou explicitní | Potřebuje heat mapy a podobné pomůcky; závěry závisí na verzi dat |
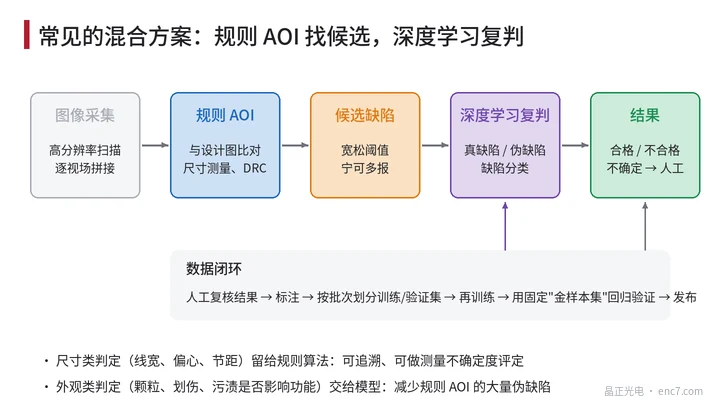
Běžná praxe je proto hybridní (Obrázek 3): AOI založené na pravidlech s volným prahem najde každého kandidáta a dokončí rozměrová rozhodnutí; deep learning jen znovu posuzuje a klasifikuje kandidáty jako «pravá vada nebo pseudo-vada» a pochybné jdou k člověku. Jen s dobrými kusy může model detekce anomálií také předtřídit — ale odpovídá jen «vypadá to jako dobrý kus?», ne typ vady.
Obrazy a vzorky: nejdřív spočítejte objem dat
Rozlišení určuje nejmenší vada: vada by měla na obraze zabírat alespoň asi 3 pixely, takže pinhol 5 μm potřebuje měřítko pixelu ne hrubší než asi 1,7 μm. Pro zónu stop s vnitřním/vnějším poloměrem 14 mm a 20 mm je plocha asi 641 mm²; kamera 1200×10⁴ pixelů při 1,5 μm/pixel pokrývá asi 27,6 mm² na zorné pole, takže jeden kotouč potřebuje asi 23 polí, nebo asi 28 s překryvem.
Těžká část vzorkování je, že vady jsou vzácné a mnohatřídní. Zásady, které je třeba dodržet:
- Rozdělte train a validation podle šarže. Pokud obrazy stejného kotouče nebo stejné šarže jsou v obou sadách, skóre validace jsou nafouknutá.
- Nejdřív definujte pravidla označování: jak velký pinhol se počítá jako vada, zda se počítá částice na chromové rysce — napište akceptační standard, pak označujte; když označuje více lidí, měřte shodu a sporné vzorky proberte zvlášť.
- Pokryjte procesní variaci: různé šarže povlaků, různé stavy stárnutí osvětlení a různé návrhy kotoučů musí být v trénovací sadě; nový návrh potřebuje před uvolněním revalidaci.
Matice záměn a práh
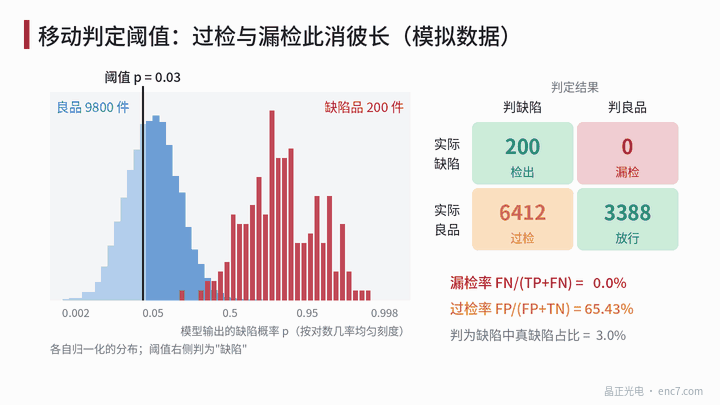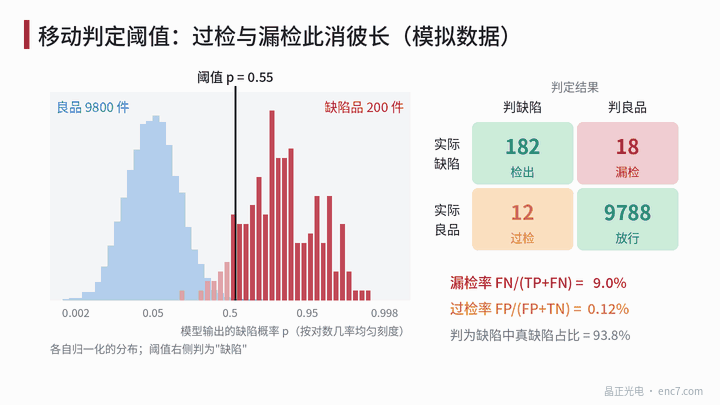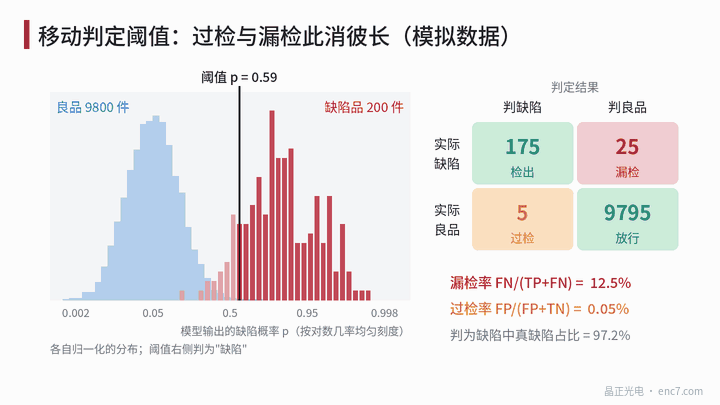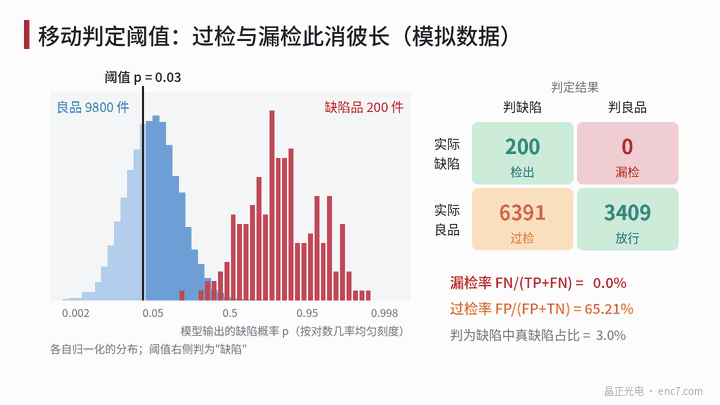
Model vydává pro každého kandidáta pravděpodobnost vady p; nad prahem se nazývá vadou. Čtyři výsledky tvoří matici záměn: detekce (TP), escape (FN), overkill (FP), průchod (TN). Běžné metriky:
míra escape = FN / (TP + FN), míra overkillu = FP / (FP + TN)
Příklad (simulovaná data, 10000 kusů, 2 % vadnost): při prahu 0,5 13 escape (6,5 %), 17 overkillů (0,17 %) a pravé vady jsou 91,7 % kusů nazvaných vadnými. Při prahu 0,31 klesají escape na 2 (1,0 %) a overkilly stoupají na 134 (1,37 %).
Práh by se měl volit podle nákladů. Předpokládejme, že náklady jedné uniklé vady v terénu jsou 50× náklady jednoho overkillu (navíc překontrola nebo falešný zmetek) (předpoklad); celkové náklady = 50·FN + FP jsou v tomto příkladu minimální při prahu asi 0,31, rovné 234, proti 667 při výchozím 0,5 (Obrázek 2). 0,5 je jen matematický střed, ne inženýrské optimum.
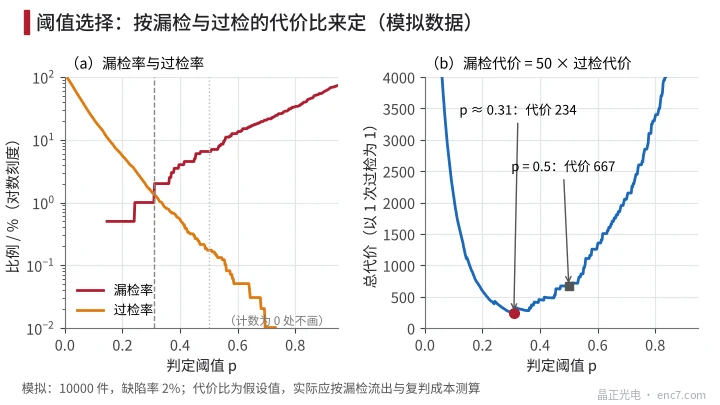
Sledujte také efekt základní míry nízké vadnosti: při jen 2 % vadách i míra overkillu 1,37 % znamená, že asi čtyři desetiny kusů nazvaných vadnými jsou stále dobré. Právě proto je třeba udržet kanál lidské překontroly.
Kolik vzorků k důkazu míry escape
Údaj «2 escape / 200 = 1,0 %» má sám statistickou nejistotu; pod binomickým rozdělením je 95% horní mez spolehlivosti asi 3,1 %. Aby se při nule escape ve verifikaci dokázalo, že míra escape není vyšší než p, je potřeba
n ≥ ln(1 − CL) / ln(1 − p)
vadných vzorků. Při spolehlivosti CL = 95 % a p = 1 % je n ≈ 299; při p = 0,5 % asi 598; při povoleném 1 escape potřebuje p = 1 % asi 473. U produktu jako kódový kotouč s velmi nízkou vadností často trvá dlouho nashromáždit několik set skutečných vadných vzorků — nejpraktičtější úzké hrdlo před nasazením deep-learning kontroly.
Inženýrské body
- Rozměrová rozhodnutí nechte pravidlovým algoritmům; deep learning ať jen znovu posuzuje vzhled — zachováte sledovatelnost měření a ořežete pseudo-vady.
- Práh nastavte podle «náklady escape ÷ náklady overkillu» a vykreslete overkill a escape proti prahu na validační sadě; nevolte výchozí 0,5.
- Ověření míry escape potřebuje alespoň asi 3/p vadných vzorků s nulou escape; když vzorků ubývá, poctivě reportujte horní mez spolehlivosti.
- Rozdělte train a validation podle šarže; nikdy nenechte obrazy stejného kotouče přecházet mezi sadami.
- Držte pevnou sadu zlatých vzorků (včetně hraničních vad každé třídy) a po každé aktualizaci modelu nebo změně kamery/světla znovu spusťte regresi.
- Po nasazení sledujte drift skórového rozdělení; posun skóre dobrých kusů nahoru se často objeví dřív, než stoupne míra overkillu, a signalizuje stárnutí osvětlení nebo změnu procesu.
Shrnutí
Hodnota deep learningu ve vizuální kontrole kódových kotoučů je především filtrovat záplavu pseudo-vad z AOI založeného na pravidlech, ne nahradit rozměrové měření. Jeho výkon určují vzorky, popisky a práh: práh volte podle nákladů, míru escape dokažte dostatkem vadných vzorků a model dál validujte napříč šaržemi a změnami procesu. Zacházejte s ním jako s měřicím systémem, který je třeba řídit, ne jako s černou skříňkou, a zůstane spolehlivý.
Překlad čínského originálu (0199). ENC7 – výrobce kódových kotoučů (poptávka) · Odborné články · https://enc7.com
© Langfang Jingzheng Optoelectronic Technology Co., Ltd. Všechna práva vyhrazena. Článek vznikl s pomocí AI.