Prüfung, Zuverlässigkeit und Qualität
Deep Learning für die visuelle Prüfung von Teilscheiben: Was es kann und worauf zu achten ist
Regelbasiertes AOI verfehlt Maßfehler nie, wird aber oft von Pseudo-Defekten wie Partikeln und Flecken überflutet; Deep Learning trennt Erscheinungsklassen gut, hängt aber von Proben und Schwellen ab. Der Artikel vergleicht beide Einsatzbereiche, zeigt mit simulierten Daten den Trade-off von Schwelle, Overkill und Escape sowie eine kostenoptimale Schwelle und berechnet, wie viele Defektproben nötig sind, um eine Escape-Rate zu verifizieren.
Die visuelle Prüfung von Teilscheiben sucht ein buntes Mix von Defekten: Chrom-Pinholes, Restchrom-Brücken, unterbrochene Linien, Kratzer, Partikel, Randabsplitterungen, Flecken. Regelbasiertes AOI kann das Bild pixelweise mit dem Entwurf vergleichen und ist bei Maßentscheidungen zuverlässig, aber empfindlich gegen „anders“ und stumpf gegen „ob anders zählt“; eine Scheibe kann Dutzende Kandidaten werfen, meist Staub und harmlose Randwelligkeit, und die menschliche Nachprüfung schließt ab. Deep Learning scheint genau diese Lücke zu füllen – verwandelt das Problem aber von „Parameter tunen“ in „Daten und Schwellen managen“.
Was regelbasiertes AOI und Deep Learning jeweils gut können
| Dimension | Regelbasiertes AOI | Deep Learning |
|---|---|---|
| Prinzip | Vergleich mit Entwurf oder Gold-Muster, Schwellen, Morphologie, Maßmessung | Defektmerkmale aus gelabelten Proben lernen; Klasse oder pixelweise Segmentierung ausgeben |
| Benötigte Proben | Praktisch keine Defektproben | Genug repräsentative gelabelte Proben |
| Maßentscheidungen | Stark; Unsicherheitsbewertung möglich | Schwach; nicht als direkte Messung geeignet |
| Erscheinungsentscheidungen | Schwach; viele Pseudo-Defekte | Stark; kann Partikel und Flecken von echten Defekten trennen |
| Beleuchtungs-/Prozessdrift | Empfindlich; wiederholtes Nachstellen | Relativ robust gegen Variationen im Trainingsset; ungedeckte können scheitern |
| Interpretierbarkeit und Rückverfolgbarkeit | Regeln sind explizit | Braucht Heatmaps und ähnliche Hilfen; Schlüsse hängen von der Datenversion ab |
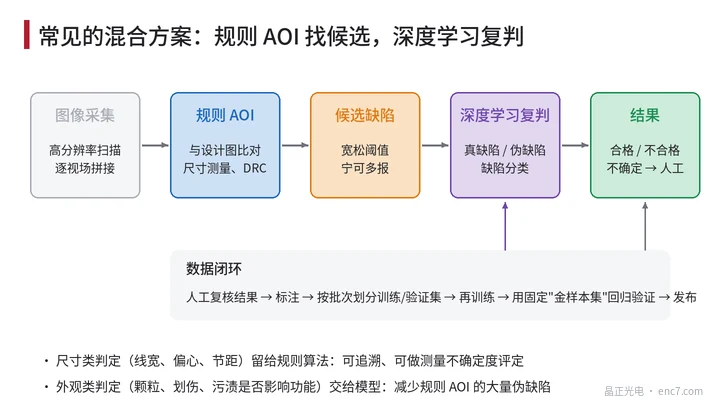
Eine gängige Praxis ist deshalb hybrid (Abb. 3): Regelbasiertes AOI mit lockerer Schwelle findet jeden Kandidaten und schließt Maßentscheidungen ab; Deep Learning beurteilt und klassifiziert Kandidaten nur als „echter Defekt oder Pseudo-Defekt“, und Zweifel gehen zum Menschen. Nur mit Gutteilen kann ein Anomalie-Erkennungsmodell auch vorsortieren – aber es beantwortet nur „sieht es wie ein Gutteil aus?“, nicht den Defekttyp.
Bilder und Proben: zuerst das Datenvolumen zählen
Die Auflösung setzt der kleinste Defekt: Ein Defekt sollte mindestens etwa 3 Pixel auf dem Bild belegen, also braucht ein 5-μm-Pinhole eine Pixelgröße nicht gröber als etwa 1,7 μm. Für eine Spurzone mit Innen-/Außenradius 14 mm und 20 mm ist die Fläche etwa 641 mm²; eine 1200×10⁴-Pixel-Kamera bei 1,5 μm/Pixel deckt etwa 27,6 mm² pro Sichtfeld ab, also braucht eine Scheibe etwa 23 Felder, oder etwa 28 mit Überlappung.
Der harte Teil der Probenahme ist, dass Defekte selten und vielklassig sind. Prinzipien, die einzuhalten sind:
- Train und Validation nach Charge splitten. Liegen Bilder derselben Scheibe oder Charge in beiden Mengen, sind Validierungsscores aufgeblasen.
- Labelregeln zuerst definieren: ab welcher Größe ein Pinhole als Defekt zählt, ob ein Partikel auf einer Chromlinie zählt – Annahmevorschrift schreiben, dann labeln; bei mehreren Labelern Übereinstimmung messen und strittige Proben gesondert besprechen.
- Prozessvariation abdecken: unterschiedliche Beschichtungschargen, unterschiedliche Beleuchtungsalterungszustände und unterschiedliche Scheibendesigns müssen im Trainingsset vorkommen; ein neues Design braucht vor Freigabe eine Re-Validierung.
Konfusionsmatrix und Schwelle
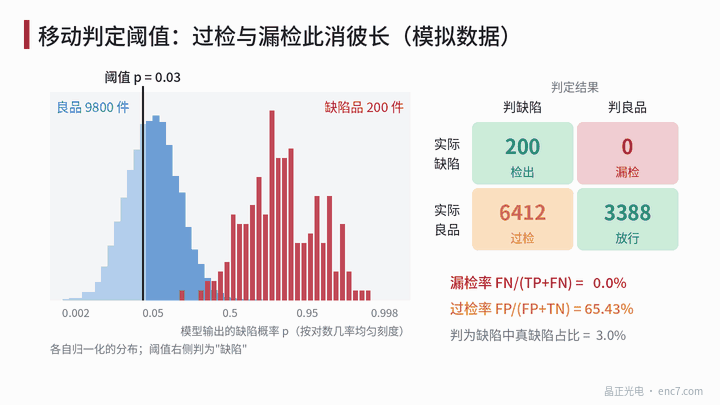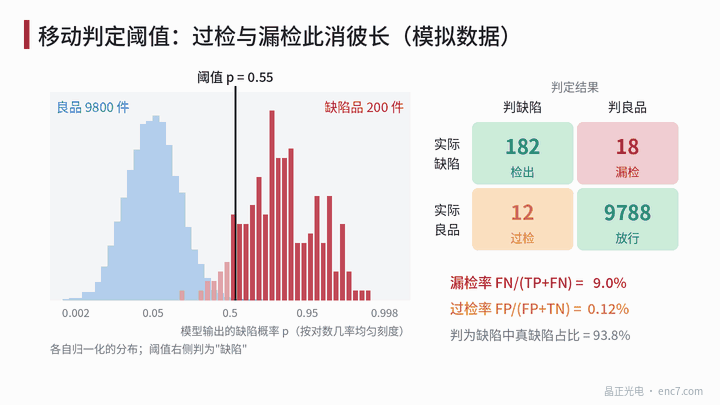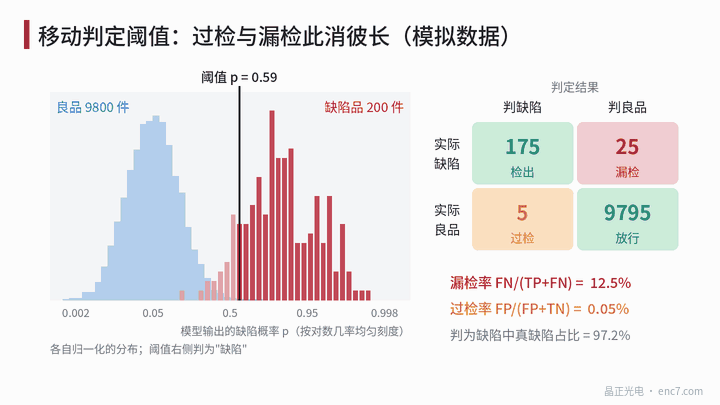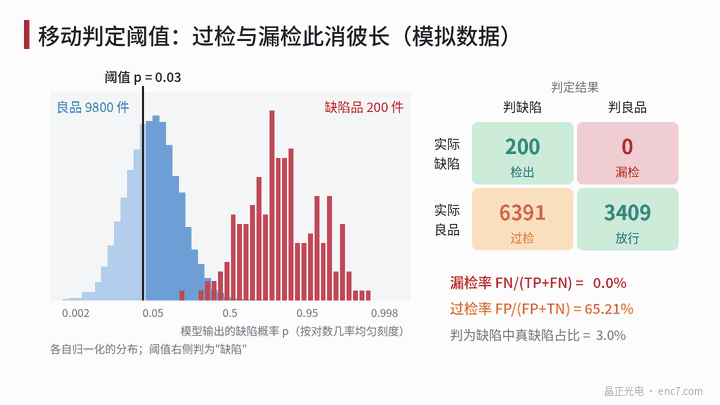
Das Modell gibt für jeden Kandidaten eine Defektwahrscheinlichkeit p aus; oberhalb der Schwelle heißt er Defekt. Vier Ausgänge bilden die Konfusionsmatrix: Detection (TP), Escape (FN), Overkill (FP), Pass (TN). Übliche Metriken:
Escape-Rate = FN / (TP + FN), Overkill-Rate = FP / (FP + TN)
Beispiel (simulierte Daten, 10000 Stück, 2 % Defektrate): bei Schwelle 0,5 13 Escapes (6,5 %), 17 Overkills (0,17 %), und echte Defekte sind 91,7 % der als defekt gerufenen Stücke. Bei Schwelle 0,31 fallen Escapes auf 2 (1,0 %) und Overkills steigen auf 134 (1,37 %).
Die Schwelle sollte nach Kosten gewählt werden. Angenommen, die Kosten eines entkommenen Defekts im Feld sind 50-mal die Kosten eines Overkills (eine Extra-Nachprüfung oder ein Fehlausschuss) (angenommen); Gesamtkosten = 50·FN + FP sind in diesem Beispiel bei etwa Schwelle 0,31 minimal, gleich 234, gegenüber 667 bei Default 0,5 (Abb. 2). 0,5 ist nur die mathematische Mitte, kein Ingenieuroptimum.
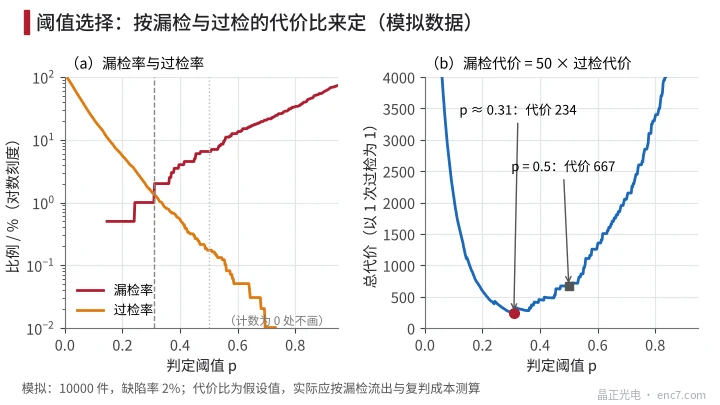
Achten Sie auch auf den Basisraten-Effekt niedriger Defektrate: Bei nur 2 % Defekten bedeutet selbst eine Overkill-Rate von 1,37 %, dass etwa vier Zehntel der als defekt gerufenen Stücke noch gut sind. Genau deshalb muss ein menschlicher Nachprüfungskanal bleiben.
Wie viele Proben, um eine Escape-Rate zu beweisen
Die Zahl „2 Escapes / 200 = 1,0 %“ hat selbst statistische Unsicherheit; unter Binomialverteilung liegt die 95%-Obere-Vertrauensgrenze bei etwa 3,1 %. Um zu beweisen, dass die Escape-Rate nicht höher als p ist bei null Escapes in der Verifikation, braucht man
n ≥ ln(1 − CL) / ln(1 − p)
Defektproben. Bei Konfidenz CL = 95 % und p = 1 % ist n ≈ 299; bei p = 0,5 % etwa 598; bei zulässigem 1 Escape braucht p = 1 % etwa 473. Bei einem Produkt wie der Teilscheibe mit sehr niedriger Defektrate dauert das Ansammeln einiger hundert echter Defektproben oft lange – der praktischste Engpass vor dem Live-Gang der Deep-Learning-Prüfung.
Ingenieurpunkte
- Maßentscheidungen den Regelalgorithmen überlassen; Deep Learning nur Erscheinung nachbeurteilen – Messrückverfolgbarkeit erhalten und Pseudo-Defekte reduzieren.
- Schwelle nach „Escape-Kosten ÷ Overkill-Kosten“ setzen und Overkill sowie Escape über der Schwelle auf dem Validierungsset plotten; nicht default auf 0,5 gehen.
- Verifikation einer Escape-Rate braucht mindestens etwa 3/p Defektproben mit null Escapes; bei knappen Proben die obere Vertrauensgrenze ehrlich berichten.
- Train und Validation nach Charge splitten; nie Bilder derselben Scheibe über Mengen mischen.
- Ein festes Gold-Proben-Set halten (einschließlich Grenzdefekte jeder Klasse) und nach jedem Modell-Update oder Kamera-/Lichtwechsel Regression erneut fahren.
- Nach dem Live-Gang Drift der Score-Verteilung überwachen; eine Aufwärtsverschiebung der Gutteil-Scores erscheint oft vor dem Anstieg der Overkill-Rate und signalisiert Beleuchtungsalterung oder Prozessänderung.
Zusammenfassung
Der Wert von Deep Learning in der visuellen Prüfung von Teilscheiben liegt vor allem darin, die Flut von Pseudo-Defekten aus regelbasiertem AOI zu filtern, nicht Maßmessung zu ersetzen. Seine Leistung setzt sich aus Proben, Labels und Schwelle zusammen: Schwelle nach Kosten wählen, Escape-Rate mit genug Defektproben beweisen und das Modell über Chargen und Prozessänderungen hinweg validieren. Behandelt man es als messendes System, das gemanagt werden muss, nicht als Blackbox, bleibt es zuverlässig.
Übersetzung des chinesischen Originalartikels (0199). ENC7 – Hersteller von Encoderscheiben (Anfrage) · Fachartikel · https://enc7.com
© Langfang Jingzheng Optoelectronic Technology Co., Ltd. Alle Rechte vorbehalten. Dieser Artikel wurde mit KI-Unterstützung erstellt.