Prove, affidabilità e qualità
Deep learning per l'ispezione visiva dei dischi encoder: cosa può fare e a cosa stare attenti
L’AOI basato su regole non manca mai i difetti dimensionali ma è spesso inondato da pseudo-difetti come particelle e macchie; il deep learning è bravo a separare le classi di aspetto ma dipende da campioni e soglie. L’articolo confronta i due ambiti d’uso, mostra con dati simulati il trade-off di soglia, overkill e escape e una soglia a costo ottimo, e calcola quanti campioni difettosi servono per verificare un tasso di escape.
L’ispezione visiva dei dischi encoder cerca un misto di difetti: pinholes di cromo, ponti di cromo residuo, linee interrotte, graffi, particelle, scheggiature di bordo, macchie. L’AOI basato su regole può confrontare l’immagine con il progetto pixel per pixel ed è affidabile sulle decisioni dimensionali, ma è sensibile a «diverso» e ottuso a «se diverso conta»; un disco può lanciare decine di candidati, per lo più polvere e ondulazione di bordo innocua, e un ricontrollo umano chiude il lavoro. Il deep learning sembra colmare esattamente quel vuoto — ma trasforma il problema da «sintonizzare i parametri» a «gestire dati e soglie».
Cosa sanno fare bene AOI basato su regole e deep learning
| Dimensione | AOI basato su regole | Deep learning |
|---|---|---|
| Principio | Confronto con progetto o campione oro, soglie, morfologia, misura dimensionale | Imparare le feature di difetto da campioni etichettati; output di classe o segmentazione a livello di pixel |
| Campioni necessari | Essenzialmente nessun campione difettoso | Abbastanza campioni etichettati rappresentativi |
| Decisioni dimensionali | Forti; valutazione d’incertezza possibile | Deboli; non adatte come misura diretta |
| Decisioni di aspetto | Deboli; molti pseudo-difetti | Forti; possono separare particelle e macchie dai difetti veri |
| Deriva di illuminazione / processo | Sensibile; ritocchi ripetuti | Abbastanza robusto alle variazioni coperte dal training set; quelle non coperte possono fallire |
| Interpretabilità e tracciabilità | Le regole sono esplicite | Servono heat map e simili; le conclusioni dipendono dalla versione dei dati |
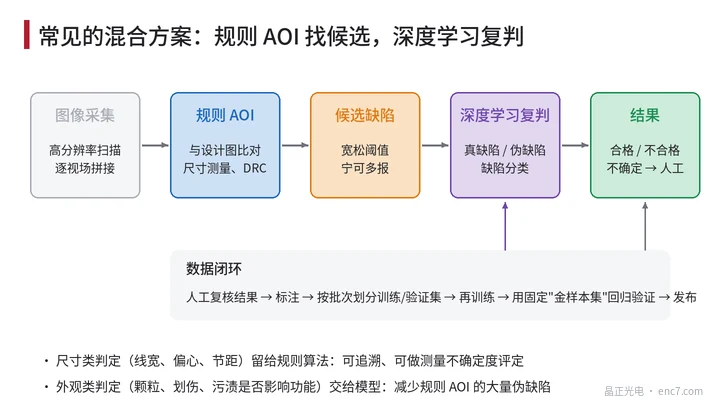
Quindi una pratica comune è ibrida (Figura 3): AOI basato su regole con soglia larga trova ogni candidato e chiude le decisioni dimensionali; il deep learning solo rivaluta e classifica i candidati come «difetto vero o pseudo-difetto», e i dubbi vanno a un umano. Solo con pezzi buoni, un modello di anomaly detection può anche fare un primo screening — ma risponde solo «sembra un pezzo buono?», non al tipo di difetto.
Immagini e campioni: contare prima il volume di dati
La risoluzione è fissata dal difetto più piccolo: un difetto dovrebbe occupare almeno circa 3 pixel sull’immagine, quindi un pinhole da 5 μm richiede una scala di pixel non più grossolana di circa 1,7 μm. Per una zona di tracce di raggi interno/esterno 14 mm e 20 mm l’area è circa 641 mm²; una telecamera da 1200×10⁴ pixel a 1,5 μm/pixel copre circa 27,6 mm² per campo di vista, quindi un disco richiede circa 23 campi, o circa 28 con sovrapposizione.
La parte dura del campionamento è che i difetti sono rari e di molte classi. Principi da rispettare:
- Separare train e validation per lotto. Se immagini dello stesso disco o dello stesso lotto compaiono in entrambi, i punteggi di validation sono gonfiati.
- Definire prima le regole di etichettatura: quanto grande un pinhole conta come difetto, se una particella su una linea di cromo conta — scrivere lo standard di accettazione, poi etichettare; quando etichettano più persone, misurare l’accordo e discutere a parte i campioni controversi.
- Coprire la variazione di processo: lotti di coating diversi, stati diversi di invecchiamento dell’illuminazione e progetti di disco diversi devono apparire nel training set; un nuovo progetto richiede ri-validazione prima del rilascio.
Matrice di confusione e soglia
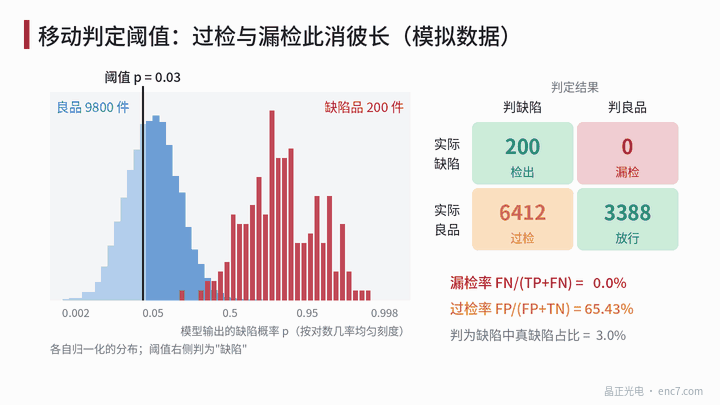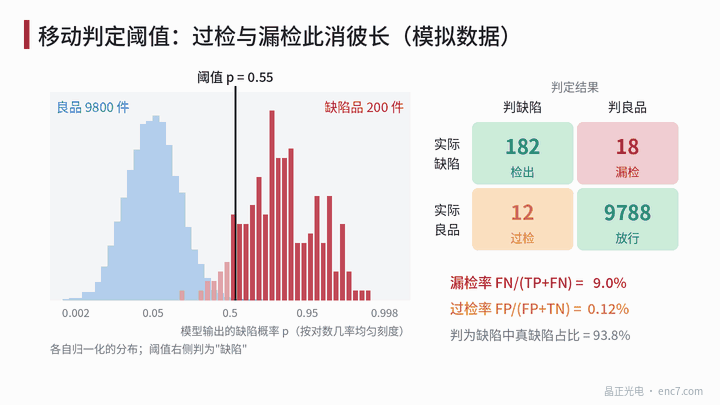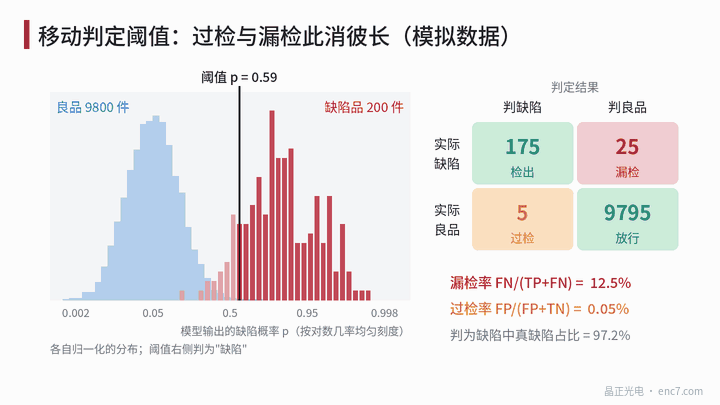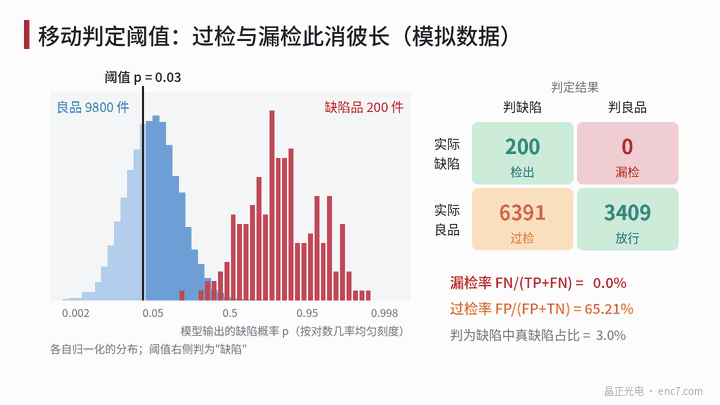
Il modello emette una probabilità di difetto p per ogni candidato; sopra la soglia è chiamato difetto. Quattro esiti formano la matrice di confusione: detection (TP), escape (FN), overkill (FP), pass (TN). Metriche comuni:
tasso di escape = FN / (TP + FN), tasso di overkill = FP / (FP + TN)
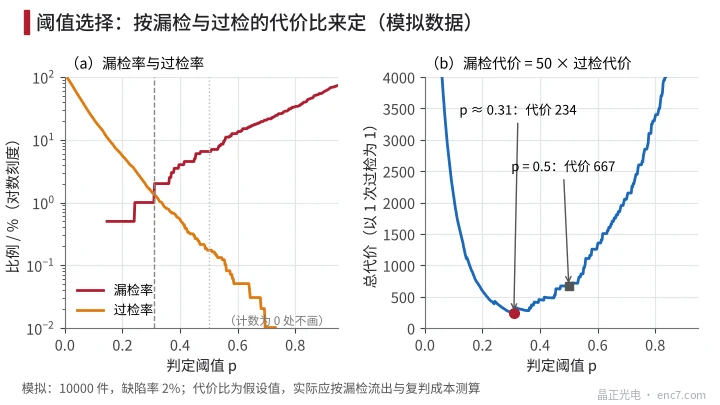
Esempio (dati simulati, 10000 pezzi, tasso di difetto 2%): a soglia 0,5, 13 escape (6,5%), 17 overkill (0,17%), e i difetti veri sono il 91,7% dei pezzi chiamati difettosi. A soglia 0,31 gli escape scendono a 2 (1,0%) e gli overkill salgono a 134 (1,37%).
La soglia va scelta per costo. Si supponga che il costo di un difetto escaped arrivato in campo sia 50 volte il costo di un overkill (un ricontrollo in più o uno scarto falso) (assunto); il costo totale = 50·FN + FP è minimo a circa soglia 0,31 in questo esempio, pari a 234, contro 667 al default 0,5 (Figura 2). 0,5 è solo il punto medio matematico, non un ottimo di ingegneria.
Attenzione anche all’effetto di base-rate di un tasso di difetto basso: a soli 2% di difetti, anche un tasso di overkill dell'1,37% significa che circa quattro decimi dei pezzi chiamati difettosi sono ancora buoni. È esattamente perché va tenuto un canale di ricontrollo umano.
Quanti campioni per dimostrare un tasso di escape
La cifra «2 escape / 200 = 1,0%» ha di per sé incertezza statistica; sotto distribuzione binomiale il limite superiore di confidenza al 95% è circa 3,1%. Per dimostrare che il tasso di escape non è superiore a p con zero escape nella verifica, il numero di campioni difettosi necessari è
n ≥ ln(1 − CL) / ln(1 − p)
A confidenza CL = 95% e p = 1%, n ≈ 299; a p = 0,5% circa 598; se si ammette 1 escape, p = 1% richiede circa 473. Per un prodotto come il disco encoder con tasso di difetto molto basso, accumulare qualche centinaio di veri campioni difettosi richiede spesso molto tempo — il collo di bottiglia più pratico prima che l’ispezione deep learning vada in produzione.
Punti di ingegneria
- Lasciare le decisioni dimensionali agli algoritmi a regole; far rivalutare al deep learning solo l’aspetto — preservando la tracciabilità di misura e tagliando gli pseudo-difetti.
- Impostare la soglia per «costo escape ÷ costo overkill» e tracciare overkill ed escape contro soglia sul validation set; non defaultare a 0,5.
- Verificare un tasso di escape richiede almeno circa 3/p campioni difettosi con zero escape; quando i campioni scarseggiano, riportare onestamente il limite superiore di confidenza.
- Separare train e validation per lotto; non far attraversare i set alle immagini dello stesso disco.
- Tenere un set fisso di campioni oro (compresi difetti di confine di ogni classe) e rilanciare la regressione dopo ogni aggiornamento di modello o cambio di telecamera/luce.
- Dopo il go-live, monitorare la deriva della distribuzione di score; uno spostamento verso l’alto degli score dei pezzi buoni compare spesso prima che salga il tasso di overkill e segnala invecchiamento dell’illuminazione o cambio di processo.
Sintesi
Il valore del deep learning nell’ispezione visiva dei dischi encoder è soprattutto filtrare l’inondazione di pseudo-difetti dell’AOI basato su regole, non sostituire la misura dimensionale. Le sue prestazioni sono fissate da campioni, etichette e soglia: scegliere la soglia per costo, dimostrare il tasso di escape con abbastanza campioni difettosi e continuare a validare il modello tra lotti e cambi di processo. Trattarlo come un sistema di misura da gestire, non come una black box, e resterà affidabile.
Traduzione dell’articolo originale cinese (0199). ENC7 – produttore di dischi encoder (richiesta) · Articoli tecnici · https://enc7.com
© Langfang Jingzheng Optoelectronic Technology Co., Ltd. Tutti i diritti riservati. Articolo realizzato con l’assistenza dell’IA.