경쟁 기술과 동향
엔코더 오차 보상에서의 머신러닝
고조파 보상과 룩업 테이블 보상은 교정 조건에서의 반복 오차에만 유효하고, 온도나 부하가 바뀌면 오차도 바뀐다. 이 글은 한 조의 예시 데이터로 정적 보상, 물리 구조 모델, 가우스 과정, 신경망, 고차 다항식을 내삽·외삽 온도에서 비교하고, 과적합, 교차 검증, 해석 가능성의 요점을 설명한다.
엔코더 오차 보상은 보통 한 온도, 한 장착 상태에서 교정하여 각도에 따른 보상 표를 얻는다. 그러나 허브와 축의 열 불일치는 편심을 바꾸고, 리드헤드 오프셋은 온도에 따라 드리프트하며, 부하는 축계를 변형시키므로 현장 오차는 교정 시의 오차와 같지 않다. 그래서 온도, 부하 등도 입력으로 삼아 머신러닝 모델로 맞추자는 제안이 나온다. 이 길은 어디까지 갈 수 있으며, 종래의 고조파 보상과 어떤 관계인가? 이 글은 한 조의 예시 데이터로 이득과 위험을 모두 계산한다.
오차 모델: e(θ)에서 e(θ, T, …)로
종래의 보상은 회전각 θ만을 독립 변수로 한다.
e(θ) = Σ [a_k·cos(kθ) + b_k·sin(kθ)]
여기서 k는 회전당 고조파 차수이고, a_k, b_k는 교정으로 얻은 계수이다. 운전 조건을 넣으면 오차는 e(θ, x)가 되며, x에는 온도 T, 부하, 회전 방향 등이 포함될 수 있다. 흔한 메커니즘은 열 불일치가 편심을 바꾸는 것(주로 1차 고조파), 부하가 축계를 변형시키는 것(저차 고조파), 리드헤드 오프셋 드리프트(신호 주기마다 1회의 보간 오차), 정역전 백래시(회전 방향에 의존)이다.
모델링에는 두 길이 있다.
- 물리 구조 모델: 고조파 형태를 유지하고 계수가 운전 조건에 따라 변하게 한다. 예를 들어 a_k(T) = a_k0 + a_k1·(T − T₀). 파라미터에 대해 선형이므로 최소제곱으로 한 번에 풀리고, 각 계수에 물리적 의미가 있다.
- 데이터 구동 모델: 가우스 과정 회귀, 소형 신경망, 기울기 부스팅 트리 등으로 cosθ, sinθ, T 등을 입력하여 오차를 직접 맞춘다. θ를 cosθ, sinθ로 부호화하는 것은 모델이 360° 주기성을 자연스럽게 만족하게 하기 위해서이다.
계산 예: 내삽과 외삽
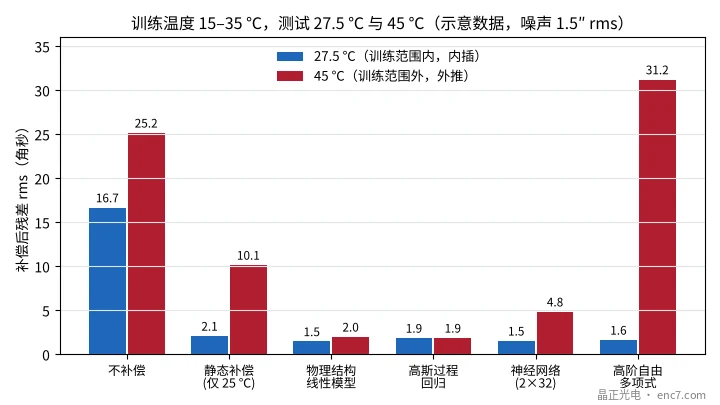
예시 데이터를 다음과 같이 구성한다. 1차 고조파 진폭 20″ + 0.6″/K·ΔT + 0.004″/K²·ΔT², 2차 고조파 8″ + 0.15″/K·ΔT, 여기에 고정된 3차(3″)와 8차(1.5″) 성분, 측정 잡음 1.5″ rms, ΔT는 25 °C에 대한 온도차. 15, 20, 25, 30, 35 °C에서 각 128점을 훈련 데이터로 잡고, 새로운 온도에서 시험 데이터를 취득한다.
| 모델 | 파라미터 수 | 27.5 °C(내삽) | 45 °C(외삽) | 5 °C(외삽) |
|---|---|---|---|---|
| 보상 없음 | — | 16.7″ | 25.2″ | 8.2″ |
| 정적 보상(25 °C만, 8차) | 17 | 2.1″ | 10.1″ | 7.8″ |
| 물리 구조(8차, 계수는 T에 선형) | 34 | 1.5″ | 2.0″ | 1.9″ |
| 가우스 과정 회귀 | 비파라미터, 640점 저장 | 1.9″ | 1.9″ | 1.9″ |
| 신경망(2층 × 32) | 1217 | 1.5″ | 4.8″ | 3.2″ |
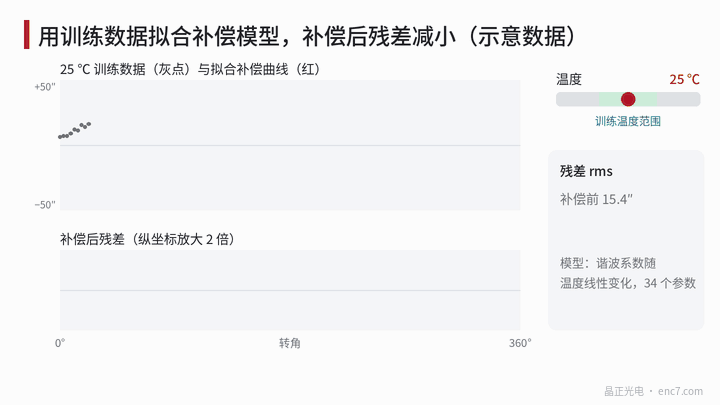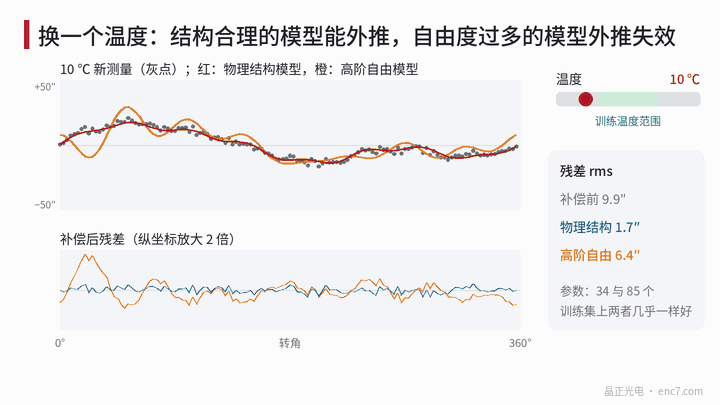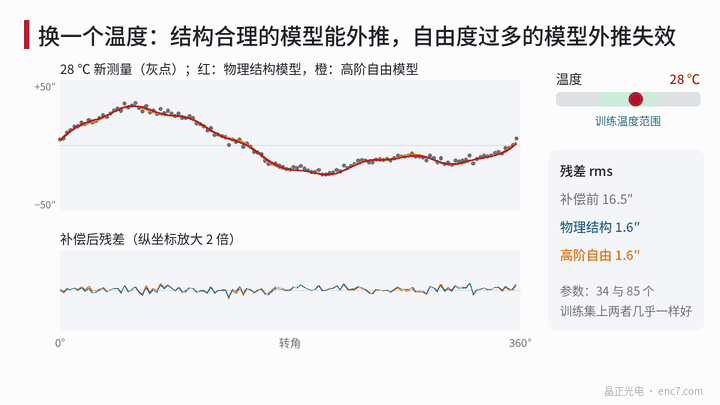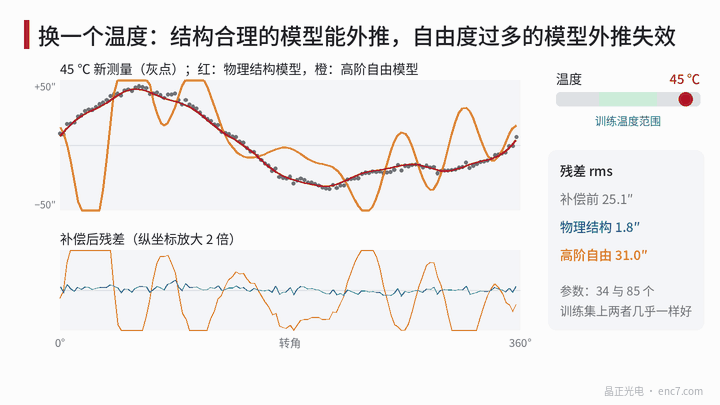
| 고차 자유 모델(계수는 T의 사차) | 85 | 1.6″ | 31.2″ | 30.3″ |
몇 가지 관찰이 있다.
- 훈련 범위 안에서는 모두가 비슷하다: 정적 보상을 제외하면 각 모델의 잔차는 1.5″ 잡음 수준에 가깝다. 내삽 성적만 보면 모델의 우열을 가릴 수 없다.
- 외삽에서 차이가 난다: 물리 구조 모델은 45 °C에서도 2.0″를 유지한다. 신경망은 4.8″까지 나빠진다. 고차 자유 모델은 31.2″에 이르러, 보상 없는 25.2″보다 못하다.
- 가우스 과정은 이번에는 좋은 결과를 냈다. 데이터에서 온도 방향으로 긴 상관 길이를 학습했기 때문이다. 다만 이런 모델은 데이터에서 멀어지면 사전 평균으로 돌아가므로, 외삽 성능은 커널과 하이퍼파라미터에 달려 있으며 일반 법칙으로 보면 안 된다.
이 데이터의 결론은 “머신러닝은 안 된다”가 아니라, 모델이 외삽할 수 있는지는 구조가 물리에 맞는지에 달려 있지, 이름에 달려 있지 않다는 것이다.
과적합과 모델 선택
훈련 오차는 모델 복잡도와 함께 단조 감소하므로, 모델이 보지 못한 데이터로 검증해야 한다. 온도에 의존하는 보상에서 시험점을 무작위로 뽑는 것은 믿을 수 없다. 같은 온도의 점은 강하게 상관되어, 무작위 분할은 모델 성적을 과대평가한다. 더 적합한 것은 온도별 leave-one-out 교차 검증이다. 매번 한 온도의 전체 데이터를 남겨 두고, 나머지 온도로 훈련한 뒤 그 온도를 예측한다.
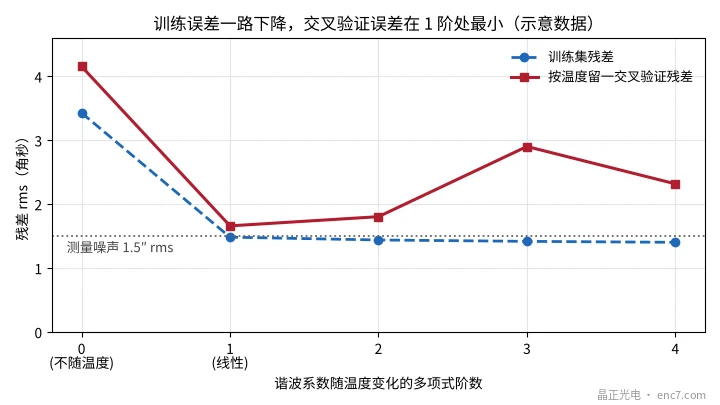
계산 예에서 다항식 차수가 0에서 4로 올라가면 훈련 잔차는 3.43″에서 1.40″로 내려가 이미 잡음보다 낮다. 교차 검증 잔차는 차례로 4.15″, 1.66″, 1.80″, 2.90″, 2.32″이며 1차에서 최소이다. 파라미터 수는 데이터 양과도 대조해야 한다. 34개 파라미터에 640점은 넉넉하고, 1217개 파라미터의 신경망은 주로 정규화로 제약된다.
해석 가능성, 안전과 배치
- 해석 가능성: 물리 구조 모델의 계수는 진단에 바로 쓸 수 있다. 예를 들어 1차 고조파의 온도에 대한 기울기는 열 불일치로 인한 편심 변화에 대응하며, 이상이 있으면 조립이나 재료까지 추적할 수 있다. 블랙박스 모델의 예측은 항별로 대조하기 어렵다.
- 적용 영역을 정의하라: 훈련이 덮은 온도·부하 범위를 기록하고, 운전 조건이 이를 넘으면 경보하거나 보수적 보상으로 되돌린다. 동시에 보상량의 진폭을 제한하여 모델이 이상값을 내지 못하게 한다.
- 기능 안전: 보상은 위치 값을 직접 바꾼다. 안전 관련 기능에 쓸 때는 알고리즘, 데이터, 도구 체인을 IEC 61508 등 규격의 절차로 검증해야 한다.
- 연산량과 지연: 물리 구조 모델은 샘플마다 수십 회의 곱셈·덧셈, 2×32 신경망은 약 천 회의 곱셈·덧셈이다. 수십 kHz 갱신률이면 임베디드 프로세서가 대체로 감당할 수 있지만, 지연과 저장은 셈에 넣어야 한다.
- 드리프트와 노화: 모델은 어느 한 시점의 데이터에 기초하므로, 재점검 주기를 정해야 한다.
공개 자료에서 데이터 구동 방법은 연구 작업과 장치 전체의 열 오차 보상에 더 자주 나타나며, 엔코더 본체 층에서는 고조파 보상과 룩업 테이블 보상이 여전히 주류이다. 더 실제적인 방법은 “그레이 박스”이다. 물리 구조 모델이 주요 오차를 맡고, 데이터 구동 모델이 나머지를 맞추며, 그 출력을 진폭 제한한다.
공학 요점
- 먼저 반복 오차를 깨끗이 보상하라: 정적 고조파 보상은 여전히 기초이다. 계산 예에서는 내삽 온도의 오차를 16.7″에서 2.1″로 낮춘다.
- 물리 구조를 모델에 써 넣어라: 계수가 온도에 대해 선형으로 변하는 모델은 파라미터가 34개뿐이며, 내삽과 외삽이 모두 안정하다.
- 운전 조건별로 leave-one-out 검증하라: 온도나 부하 묶음 전체를 남겨 두고, 점을 무작위로 뽑지 마라. 그렇지 않으면 효과를 과대평가한다.
- 훈련 범위는 사용 범위보다 넓어야 한다: 계산 예의 고차 자유 모델은 45 °C로 외삽할 때 보상 없음보다 못하다.
- 입력에 주기성을 부호화하라: θ 자체가 아니라 cosθ, sinθ를 입력으로 쓴다.
- 배치 시 진폭을 제한하고 적용 영역을 감시하라: 훈련 범위를 넘으면 경보하거나 보수적 보상으로 되돌린다.
정리
머신러닝은 온도, 부하 같은 운전 조건을 오차 보상에 넣을 수 있지만, 훈련 범위 안에서는 물리 구조 모델과 차이가 크지 않고, 차이는 외삽, 해석 가능성, 검증 비용에서 나타난다. 성패를 가르는 것은 모델 구조, 데이터 범위, 검증 방법이다. 엔코더에서는 고조파 물리 모델을 주축으로 하고 데이터 구동 모델로 보완하는 것이, 현재로서는 더 튼튼한 길이다.
중국어 원문 기사 번역 (0188). ENC7 코드 디스크 제조사 (문의) · 기술 자료 · https://enc7.com
© Langfang Jingzheng Optoelectronic Technology Co., Ltd. 무단 전재를 금합니다. 이 글은 AI의 도움을 받아 작성되었습니다.