竞争技术与趋势
机器学习在编码器误差补偿中的应用
谐波和查表补偿只对标定条件下的可重复误差有效,温度、负载变化后误差会变。本文用一组示意数据比较静态补偿、物理结构模型、高斯过程、神经网络和高阶多项式在内插与外推温度下的表现,说明过拟合、交叉验证和可解释性的要点。
编码器的误差补偿通常在一个温度、一种安装状态下标定,得到一张随角度变化的补偿表。可是轮毂和轴的热失配会改变偏心,读数头的偏置会随温度漂移,负载会让轴系变形,现场误差并不等于标定时的误差。于是有人提出:把温度、负载等也作为输入,用机器学习模型去拟合。这条路能走多远?它和传统谐波补偿是什么关系?本文用一组示意数据把收益和风险都算出来。
误差模型:从 e(θ) 到 e(θ, T, …)
传统补偿只以转角 θ 为自变量:
e(θ) = Σ [a_k·cos(kθ) + b_k·sin(kθ)]
其中 k 为每转谐波次数,a_k、b_k 为标定得到的系数。考虑工况后,误差变为 e(θ, x),x 可以包括温度 T、负载、转向等。常见的机理有:热失配改变偏心(主要影响 1 次谐波)、负载使轴系变形(低阶谐波)、读数头偏置漂移(每信号周期 1 次的细分误差)、正反转回差(与转向有关)。
建模有两条路:
- 物理结构模型:保持谐波形式,让系数随工况变化,例如 a_k(T) = a_k0 + a_k1·(T − T₀)。它对参数是线性的,用最小二乘一次解出,每个系数都有物理含义。
- 数据驱动模型:高斯过程回归、小型神经网络、梯度提升树等,以 cosθ、sinθ、T 等为输入直接拟合误差。把 θ 编码成 cosθ、sinθ,是为了让模型天然满足 360° 周期性。
算例:内插与外推
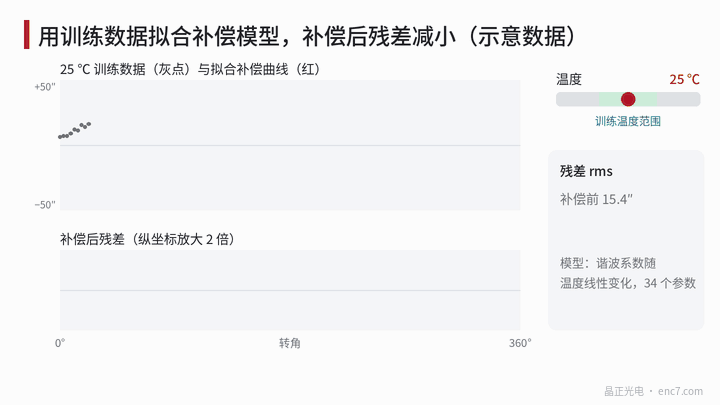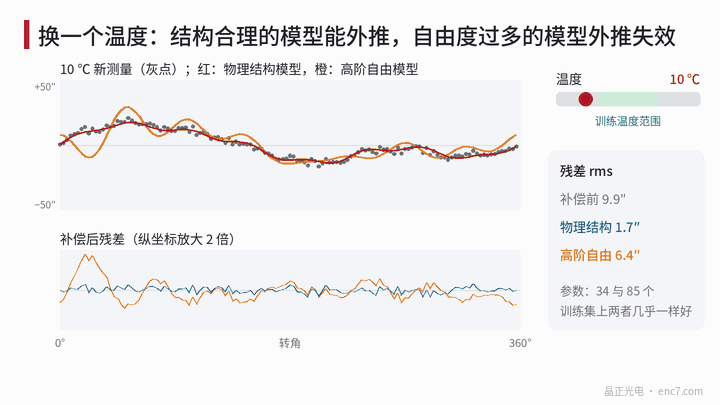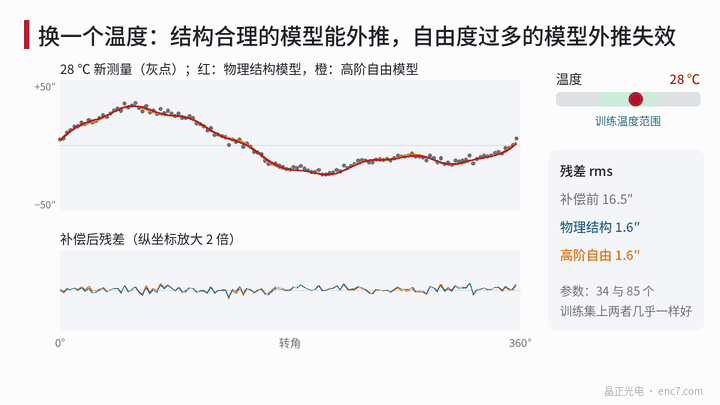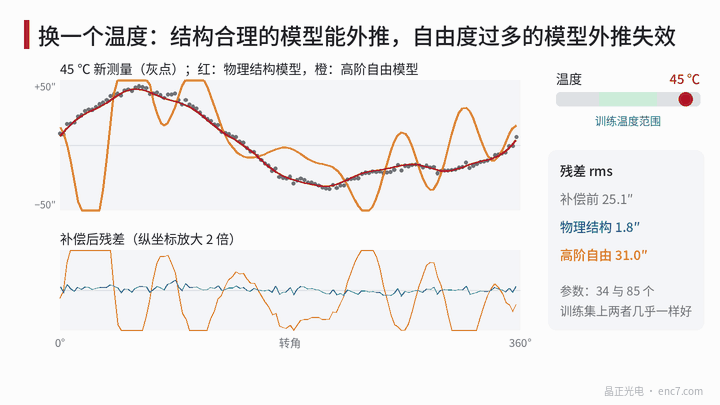
构造示意数据:1 次谐波幅值 20″ + 0.6″/K·ΔT + 0.004″/K²·ΔT²,2 次谐波 8″ + 0.15″/K·ΔT,另有固定的 3 次(3″)和 8 次(1.5″)分量,测量噪声 1.5″ rms,ΔT 为相对 25 ℃ 的温差。在 15、20、25、30、35 ℃ 各采 128 个点作为训练数据,再在新的温度下采集测试数据。
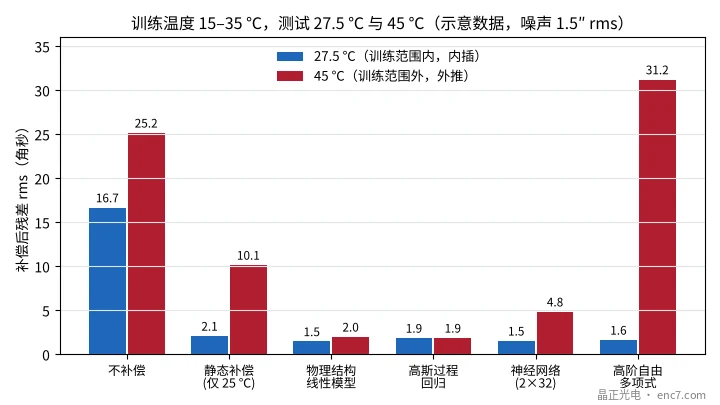
| 模型 | 参数量 | 27.5 ℃(内插) | 45 ℃(外推) | 5 ℃(外推) |
|---|---|---|---|---|
| 不补偿 | — | 16.7″ | 25.2″ | 8.2″ |
| 静态补偿(仅 25 ℃,8 阶) | 17 | 2.1″ | 10.1″ | 7.8″ |
| 物理结构(8 阶,系数随 T 线性) | 34 | 1.5″ | 2.0″ | 1.9″ |
| 高斯过程回归 | 非参数,保存 640 个点 | 1.9″ | 1.9″ | 1.9″ |
| 神经网络(2 层 × 32) | 1217 | 1.5″ | 4.8″ | 3.2″ |
| 高阶自由模型(系数随 T 四次) | 85 | 1.6″ | 31.2″ | 30.3″ |
几点观察:
- 训练范围内,大家都差不多:除静态补偿外,各模型残差都接近 1.5″ 的噪声水平。只看内插表现,分不出模型好坏。
- 外推才见分晓:物理结构模型在 45 ℃ 仍有 2.0″;神经网络退化到 4.8″;高阶自由模型达到 31.2″,比不补偿的 25.2″ 还差。
- 高斯过程这次表现不错,原因是它从数据中学到了温度方向上很长的相关长度。但这类模型在远离数据时会回到先验均值,外推表现取决于核函数和超参数,不能当作普遍规律。
这组数据的结论不是“机器学习不行”,而是:模型能不能外推,取决于结构是否符合物理,而不在于它叫什么名字。
过拟合与模型选择
训练误差随模型复杂度单调下降,所以必须用模型没见过的数据验证。对温度相关补偿,随机抽取测试点并不可靠:同一温度下的点高度相关,随机划分会高估模型表现。更合适的是按温度留一交叉验证:每次留出一个温度的全部数据,用其余温度训练再预测它。
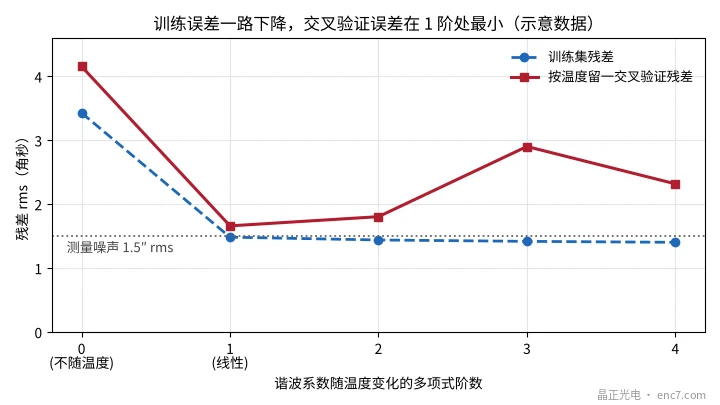
算例中,多项式阶数从 0 到 4,训练残差从 3.43″ 降到 1.40″,已低于噪声;交叉验证残差依次为 4.15″、1.66″、1.80″、2.90″、2.32″,在 1 阶处最小。参数量也要和数据量对照:34 个参数对 640 个点是宽裕的,1217 个参数的神经网络则主要靠正则化约束。
可解释性、安全与部署
- 可解释性:物理结构模型的系数可以直接诊断,例如 1 次谐波随温度的斜率对应热失配引起的偏心变化,异常时能追溯到装配或材料;黑箱模型的预测难以逐项核对。
- 定义适用域:记录训练覆盖的温度、负载范围,工况超出时报警或退回保守补偿;同时限制补偿量的幅值,防止模型输出异常值。
- 功能安全:补偿直接改变位置值,用于安全相关功能时,算法、数据和工具链都要按 IEC 61508 等标准的流程验证。
- 算力与延时:物理结构模型每个采样点几十次乘加,2×32 神经网络约千次乘加,几十 kHz 更新率下嵌入式处理器一般能承担,但要计入延时和存储。
- 漂移与老化:模型基于某一时刻的数据,需要规定复检周期。
公开资料中,数据驱动方法更多出现在研究工作和整机级的热误差补偿中;在编码器本体层面,谐波和查表补偿仍是主流。较实际的做法是“灰箱”:用物理结构模型承担主要误差,再用数据驱动模型拟合剩余部分,并对其输出限幅。
工程要点
- 先把可重复误差补干净:静态谐波补偿仍是基础,算例中它把内插温度下的误差从 16.7″ 降到 2.1″。
- 把物理结构写进模型:系数随温度线性变化的模型只有 34 个参数,内插和外推都稳定。
- 按工况留一验证:按温度或负载整组留出,不要随机抽点,否则会高估效果。
- 训练覆盖要大于使用范围:算例中高阶自由模型在 45 ℃ 外推时比不补偿还差。
- 输入要编码周期性:用 cosθ、sinθ 而不是 θ 本身作为输入。
- 部署时限幅并监控适用域:超出训练范围时报警或退回保守补偿。
小结
机器学习可以把温度、负载等工况纳入误差补偿,但在训练范围内它和物理结构模型差别不大,差别出现在外推、可解释性和验证成本上。决定成败的是模型结构、数据覆盖和验证方法。对编码器而言,以谐波物理模型为主干、数据驱动模型做补充,是目前较稳妥的路线。
延伸阅读:ENC7 编码器码盘生产厂家(中文主页) · 码盘技术文库
关于我们:晶正光电专注编码器码盘研发制造,玻璃、金属、PC 码盘均可按图定制。
官网:https://enc7.com
© 廊坊晶正光电技术有限公司 版权所有,未经书面许可不得转载、摘编。本文借助 AI 辅助创作。