競爭技術與趨勢
機器學習在編碼器誤差補償中的應用
諧波和查表補償只對標定條件下的可重複誤差有效,溫度、負載變化後誤差會變。本文用一組示意資料比較靜態補償、物理結構模型、高斯過程、神經網路和高階多項式在內插與外推溫度下的表現,說明過擬合、交叉驗證和可解釋性的要點。
編碼器的誤差補償通常在一個溫度、一種安裝狀態下標定,得到一張隨角度變化的補償表。可是輪轂和軸的熱失配會改變偏心,讀數頭的偏置會隨溫度漂移,負載會讓軸系變形,現場誤差並不等於標定時的誤差。於是有人提出:把溫度、負載等也作為輸入,用機器學習模型去擬合。這條路能走多遠?它和傳統諧波補償是什麼關係?本文用一組示意資料把收益和風險都算出來。
誤差模型:從 e(θ) 到 e(θ, T, …)
傳統補償只以轉角 θ 為自變數:
e(θ) = Σ [a_k·cos(kθ) + b_k·sin(kθ)]
其中 k 為每轉諧波次數,a_k、b_k 為標定得到的係數。考慮工況後,誤差變為 e(θ, x),x 可以包括溫度 T、負載、轉向等。常見的機理有:熱失配改變偏心(主要影響 1 次諧波)、負載使軸系變形(低階諧波)、讀數頭偏置漂移(每訊號週期 1 次的細分誤差)、正反轉回差(與轉向有關)。
建模有兩條路:
- 物理結構模型:保持諧波形式,讓係數隨工況變化,例如 a_k(T) = a_k0 + a_k1·(T − T₀)。它對引數是線性的,用最小二乘一次解出,每個係數都有物理含義。
- 資料驅動模型:高斯過程迴歸、小型神經網路、梯度提升樹等,以 cosθ、sinθ、T 等為輸入直接擬合誤差。把 θ 編碼成 cosθ、sinθ,是為了讓模型天然滿足 360° 週期性。
算例:內插與外推
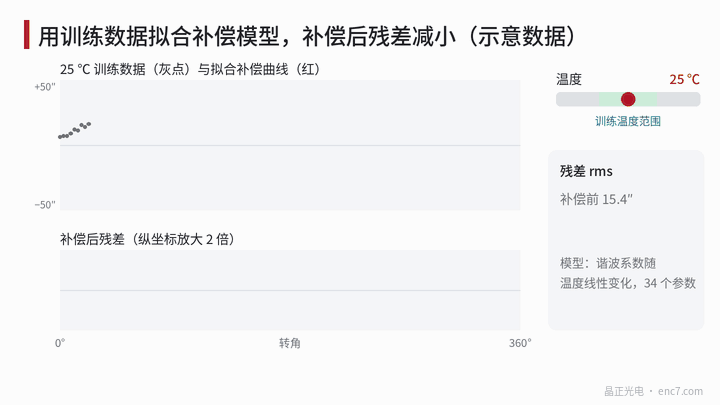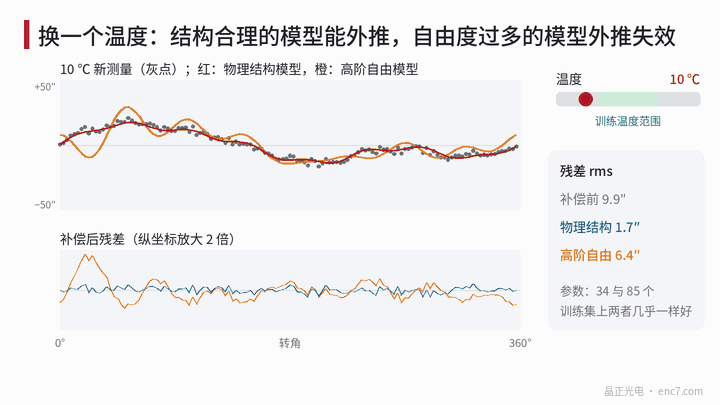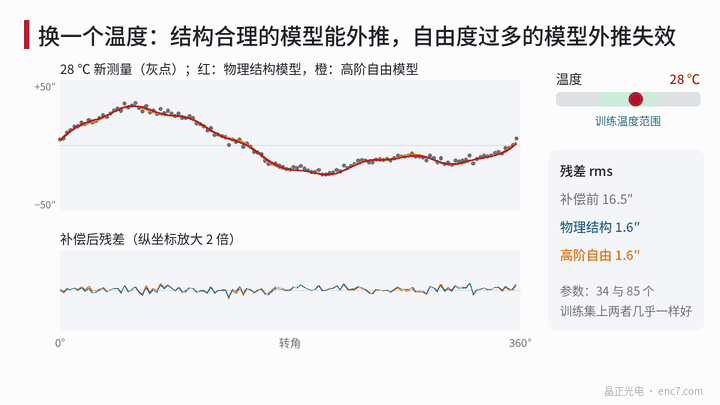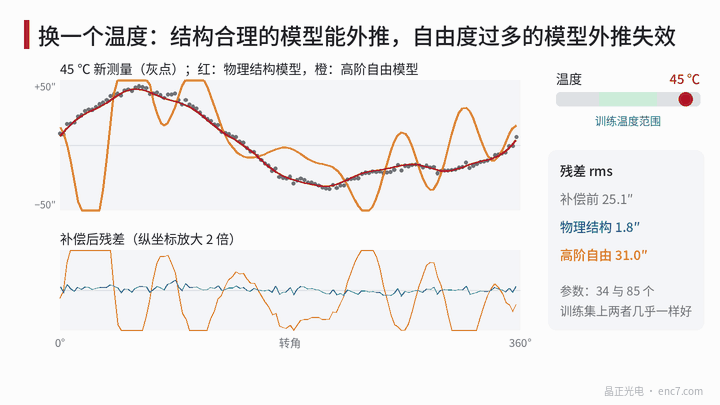
構造示意資料:1 次諧波幅值 20″ + 0.6″/K·ΔT + 0.004″/K²·ΔT²,2 次諧波 8″ + 0.15″/K·ΔT,另有固定的 3 次(3″)和 8 次(1.5″)分量,測量噪聲 1.5″ rms,ΔT 為相對 25 ℃ 的溫差。在 15、20、25、30、35 ℃ 各採 128 個點作為訓練資料,再在新的溫度下采集測試資料。
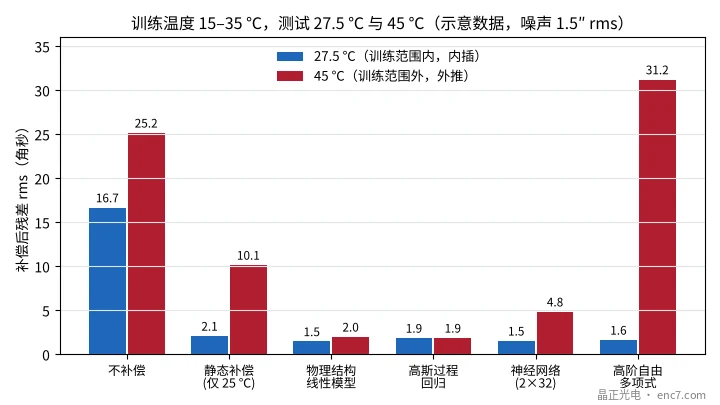
| 模型 | 引數量 | 27.5 ℃(內插) | 45 ℃(外推) | 5 ℃(外推) |
|---|---|---|---|---|
| 不補償 | — | 16.7″ | 25.2″ | 8.2″ |
| 靜態補償(僅 25 ℃,8 階) | 17 | 2.1″ | 10.1″ | 7.8″ |
| 物理結構(8 階,係數隨 T 線性) | 34 | 1.5″ | 2.0″ | 1.9″ |
| 高斯過程迴歸 | 非引數,儲存 640 個點 | 1.9″ | 1.9″ | 1.9″ |
| 神經網路(2 層 × 32) | 1217 | 1.5″ | 4.8″ | 3.2″ |
| 高階自由模型(係數隨 T 四次) | 85 | 1.6″ | 31.2″ | 30.3″ |
幾點觀察:
- 訓練範圍內,大家都差不多:除靜態補償外,各模型殘差都接近 1.5″ 的噪聲水平。只看內插表現,分不出模型好壞。
- 外推才見分曉:物理結構模型在 45 ℃ 仍有 2.0″;神經網路退化到 4.8″;高階自由模型達到 31.2″,比不補償的 25.2″ 還差。
- 高斯過程這次表現不錯,原因是它從資料中學到了溫度方向上很長的相關長度。但這類模型在遠離資料時會回到先驗均值,外推表現取決於核函式和超引數,不能當作普遍規律。
這組資料的結論不是“機器學習不行”,而是:模型能不能外推,取決於結構是否符合物理,而不在於它叫什麼名字。
過擬合與模型選擇
訓練誤差隨模型複雜度單調下降,所以必須用模型沒見過的資料驗證。對溫度相關補償,隨機抽取測試點並不可靠:同一溫度下的點高度相關,隨機劃分會高估模型表現。更合適的是按溫度留一交叉驗證:每次留出一個溫度的全部資料,用其餘溫度訓練再預測它。
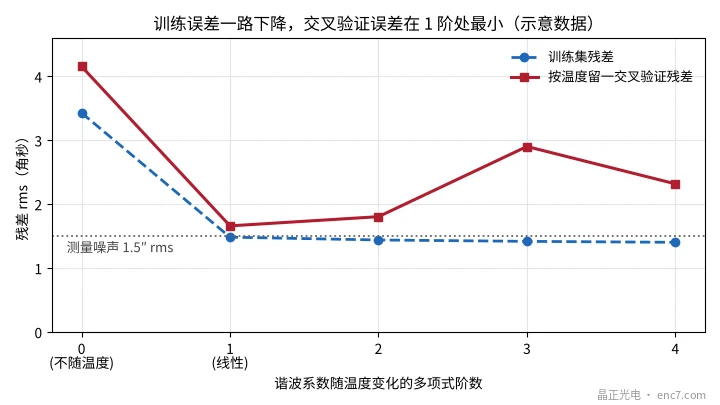
算例中,多項式階數從 0 到 4,訓練殘差從 3.43″ 降到 1.40″,已低於噪聲;交叉驗證殘差依次為 4.15″、1.66″、1.80″、2.90″、2.32″,在 1 階處最小。引數量也要和資料量對照:34 個引數對 640 個點是寬裕的,1217 個引數的神經網路則主要靠正則化約束。
可解釋性、安全與部署
- 可解釋性:物理結構模型的係數可以直接診斷,例如 1 次諧波隨溫度的斜率對應熱失配引起的偏心變化,異常時能追溯到裝配或材料;黑箱模型的預測難以逐項核對。
- 定義適用域:記錄訓練覆蓋的溫度、負載範圍,工況超出時報警或退回保守補償;同時限制補償量的幅值,防止模型輸出異常值。
- 功能安全:補償直接改變位置值,用於安全相關功能時,演算法、資料和工具鏈都要按 IEC 61508 等標準的流程驗證。
- 算力與延時:物理結構模型每個取樣點幾十次乘加,2×32 神經網路約千次乘加,幾十 kHz 更新率下嵌入式處理器一般能承擔,但要計入延時和儲存。
- 漂移與老化:模型基於某一時刻的資料,需要規定複檢週期。
公開資料中,資料驅動方法更多出現在研究工作和整機級的熱誤差補償中;在編碼器本體層面,諧波和查表補償仍是主流。較實際的做法是“灰箱”:用物理結構模型承擔主要誤差,再用資料驅動模型擬合剩餘部分,並對其輸出限幅。
工程要點
- 先把可重複誤差補乾淨:靜態諧波補償仍是基礎,算例中它把內插溫度下的誤差從 16.7″ 降到 2.1″。
- 把物理結構寫進模型:係數隨溫度線性變化的模型只有 34 個引數,內插和外推都穩定。
- 按工況留一驗證:按溫度或負載整組留出,不要隨機抽點,否則會高估效果。
- 訓練覆蓋要大於使用範圍:算例中高階自由模型在 45 ℃ 外推時比不補償還差。
- 輸入要編碼週期性:用 cosθ、sinθ 而不是 θ 本身作為輸入。
- 部署時限幅並監控適用域:超出訓練範圍時報警或退回保守補償。
小結
機器學習可以把溫度、負載等工況納入誤差補償,但在訓練範圍內它和物理結構模型差別不大,差別出現在外推、可解釋性和驗證成本上。決定成敗的是模型結構、資料覆蓋和驗證方法。對編碼器而言,以諧波物理模型為主幹、資料驅動模型做補充,是目前較穩妥的路線。
延伸閱讀:ENC7 編碼器碼盤生產廠家(中文首頁) · 碼盤技術文庫
關於我們:晶正光電專注編碼器碼盤研發製造,玻璃、金屬、PC 碼盤均可按圖客製。
官網:https://enc7.com
© 廊坊晶正光電技術有限公司 版權所有,未經書面許可不得轉載、摘編。本文藉助 AI 輔助創作。